Александър Джоганов – Световната литературна избирателна комисия

Антоан Божинов, Августовски пуч, Москва, 1991


девет изкуствени интелекта, десет книги и избори, които никой не е провеждал


Преди години Facebook ме попита кои са десетте книги, които са останали с мен. Това беше безопасен въпрос. Facebook още не се опитваше да бъде интелигентен.

Написах десет: „Махалото на Фуко“ и „Името на розата“ на Умберто Еко, „Параграф 22“ на Джоузеф Хелър, „Швейк“ на Ярослав Хашек, „Фондацията“ на Айзък Азимов, „Обявяването на серия №49“ на Томас Пинчън, „Синдромът Портной“ на Филип Рот, „Москва–Петушки“ на Венедикт Ерофеев, „Вавилонската библиотека“ на Хорхе Луис Борхес и „Пътеводител на галактическия стопаджия“ на Дъглас Адамс. Два Еко в десетка не е особено разумен начин да се съставя литературен канон. Но никой не ме беше питал за канона. Бяха ме питали за мен.

Оказа се, че същата игра са играли много хора. През 2014 г. Facebook анализира повече от 130 000 подобни статуса.[1] На първо място излезе поредицата за Хари Потър, следвана от „Да убиеш присмехулник“ и „Властелинът на пръстените“.[1] „Ана Каренина“ беше 83-та, „Престъпление и наказание“ – 84-то.[1] Нищо страшно. Сто и трийсет хиляди души бяха казали кои книги са останали с тях и от личните им истории се беше получил списък. Никой не твърдеше, че е верен.

После дойде изкуственият интелект. Той направи нещо, което доскоро изглеждаше почти невъзможно: направи Google досаден. Вместо да получиш десет линка, да затвориш прозореца за бисквитки, да прескочиш две реклами и да откриеш, че отговорът не е там, просто задаваш въпроса. Свикнахме с това подозрително бързо.

Всичко е прекрасно, когато въпросът има отговор. Колко седмици има в годината? Колко време се варят яйца? Кога е Великден? Сред най-често задаваните въпроси в Google се среща дори „Какъв е смисълът на живота?“, макар че там проверката на отговора е малко по-трудна.[2] Но какво става, когато зададем въпрос, на който по принцип няма верен отговор?

Тогава направих грешката да попитам ChatGPT:

“Name ten works of literature that an educated person should have read. Do not explain your choices. Give only the author and title, ranked from 1 to 10.”

Получих Омир („Одисея“), Софокъл („Едип цар“), Данте („Божествена комедия“), Сервантес („Дон Кихот“), Шекспир („Хамлет“), Гьоте („Фауст“), Остин („Гордост и предразсъдъци“), Достоевски („Братя Карамазови“), Толстой („Война и мир“) и Кафка („Процесът“) – в тази подредба. Нищо особено. Точно от онези книги, за които човек може да спори с половината списък, но не може да възкликне: „Какви са тези хора?“ Това можеше да е краят на историята.

После попитах Claude. Той даде Омир („Одисея“), Данте („Божествена комедия“), Шекспир („Хамлет“), Сервантес („Дон Кихот“), Толстой („Война и мир“), Достоевски („Престъпление и наказание“), Джойс („Одисей“), Маркес („Сто години самота“), Вирджиния Улф („Към фара“) и Тони Морисън („Beloved“).

Хм.

Попитах Mistral, френския голям езиков модел. Той даде Омир („Одисея“), Данте („Божествена комедия“), Шекспир („Хамлет“), Сервантес („Дон Кихот“), Достоевски („Престъпление и наказание“), Толстой („Война и мир“), Джойс („Одисей“), Кафка („Процесът“), Вирджиния Улф („Към фара“) и Маркес („Сто години самота“).

Три модела не са целия свят. Освен това всички са създадени на Запад. Ако питаш за световния литературен канон само американци и французин, не си направил кой знае какъв експеримент.

Затова отидохме в Китай.

DeepSeek даде Омир („Илиада“), Данте („Божествена комедия“), Шекспир („Хамлет“), Сервантес („Дон Кихот“), Остин („Гордост и предразсъдъци“), Дикенс („Големите надежди“), Достоевски („Престъпление и наказание“), Толстой („Война и мир“), Оруел („1984“) и Тони Морисън („Beloved“).

Qwen даде Омир („Одисея“), Шекспир („Хамлет“), Сервантес („Дон Кихот“), Данте („Божествена комедия“), Остин („Гордост и предразсъдъци“), Достоевски („Престъпление и наказание“), Толстой („Война и мир“), Маркес („Сто години самота“), Оруел („1984“) и Тони Морисън („Beloved“).

Двата китайски изкуствени интелекта не намериха място за нито един китайски писател. Това вече беше забавно.

Оставаше Индия. Трудно е да си представим по-добър начин да развалим един предполагаем западен канон: огромна страна, огромна литературна традиция, множество езици, култура, която със сигурност не започва с Омир и не чака Сервантес, за да открие разказването.

Sarvam даде Сервантес („Дон Кихот“), Шекспир („Хамлет“), Данте („Божествена комедия“), Омир („Одисея“), Достоевски („Престъпление и наказание“), Толстой („Ана Каренина“), Остин („Гордост и предразсъдъци“), Кафка („Процесът“), Маркес („Сто години самота“) и Чинуа Ачебе („Things Fall Apart“).

Нито един индийски автор.

В този момент вече имахме проблем. Всички списъци бяха прекалено прилични по един и същи начин.

Затова добавихме Gemini. Той даде Омир („Одисея“), Данте („Божествена комедия“), Шекспир („Хамлет“), Сервантес („Дон Кихот“), Остин („Гордост и предразсъдъци“), Мелвил („Моби Дик“), Достоевски („Престъпление и наказание“), Толстой („Война и мир“), Джойс („Одисей“) и Маркес („Сто години самота“).

След седем модела резултатът вече трудно можеше да бъде подминат като забавна случайност. Шестима автори присъстваха във всичките седем списъка: Омир, Данте, Шекспир, Сервантес, Толстой и Достоевски.

При книгите имаше малки разлики, но съвсем малко. Шест модела избраха „Одисея“, един – „Илиада“. Шест избраха „Война и мир“, един – „Ана Каренина“. При Достоевски шест избраха „Престъпление и наказание“, един – „Братя Карамазови“. Авторите бяха седем от седем. Книгите – шест от седем.

Тук вече спрях да се интересувам кой е „прав“ – нямаше как да има прав. Няма мерна единица, с която „Война и мир“ да победи „Мадам Бовари“, нито литературен метър, на който „Хамлет“ да е 9,74, а „Енеида“ – 8,61. И все пак седем различни модела, създадени от различни компании в различни части на света, бяха намерили шест еднакви автори на въпрос, който няма верен отговор.

Особено ме дразнеха двамата руснаци. Шекспир някак го преглъщах. Омир и Данте също имат удобното предимство да стоят почти в началото на огромни литературни традиции. Сервантес може да бъде обявен за баща на модерния роман и човек поне има готово изречение, с което да си обясни присъствието му. Но защо Толстой и Достоевски? Защо двама руски писатели от XIX век получават две от десетте места във всички американски, френски, китайски и индийски списъци? Защо не Дикенс, Пруст, Флобер, Гьоте, Вергилий или Борхес?

Очевидното обяснение беше, че Путин е купил изкуствения интелект. То имаше два недостатъка: беше глупаво и почти сигурно невярно.

Но вече нямахме избор.

Трябваше да попитаме руснаците.

Първо попитахме Alice, изкуствения интелект на Yandex. Той даде Толстой („Война и мир“), Достоевски („Престъпление и наказание“), Остин („Гордост и предразсъдъци“), Дикенс („Големите надежди“), Оруел („1984“), Шекспир („Хамлет“), Мелвил („Моби Дик“), Марк Твен („Приключенията на Хъкълбери Фин“), Вирджиния Улф („Към фара“) и Джойс („Одисей“).

Разбира се.

Омир беше изчезнал, Данте беше изчезнал, Сервантес беше изчезнал. Но Толстой и Достоевски не само бяха останали – бяха се качили на първите две места.

Един руски изкуствен интелект, разбира се, не е кой знае какъв контрол. Ако попиташ французин за десетте най-важни сирена на света, има известна вероятност Франция да се представи достойно. Затова намерихме втори руски модел – GigaChat на Sber.

Той даде Толстой („Война и мир“), Достоевски („Престъпление и наказание“), Омир („Одисея“), Шекспир („Хамлет“), Сервантес („Дон Кихот“), Гьоте („Фауст“), Данте („Божествена комедия“), Джойс („Одисей“), Пруст („По следите на изгубеното време“) и Маркес („Сто години самота“). Отново Толстой – номер едно, Достоевски – номер две.

Тук експериментът започна да се държи неприлично.

След девет модела – американски, френски, китайски, индийски и руски – само трима автори бяха останали във всички списъци: Шекспир, Толстой и Достоевски. При книгите картината беше малко по-различна: осем модела избраха „Война и мир“, един – „Ана Каренина“; осем избраха „Престъпление и наказание“, един – „Братя Карамазови“. Авторите – девет от девет, книгите – осем от девет.

Двата руски модела бяха направили и още нещо. И двата бяха дали една и съща двойка, с едни и същи книги, на едни и същи места: Толстой („Война и мир“) – номер едно; Достоевски („Престъпление и наказание“) – номер две.

Руснаците поне бяха лесни за разбиране. Националните литератури отдавна умеят да обясняват на собствените си граждани, че техният болен е най-здравият болен на света. По-трудният въпрос беше защо същите двама болни са толкова здрави и в Китай, Индия, Франция и Съединените щати.

Около твърдото ядро започваше хаосът. Остин („Гордост и предразсъдъци“) се появяваше често, както и Маркес („Сто години самота“). Джойс („Одисей“) и Кафка („Процесът“) се появяваха, изчезваха и пак се връщаха. Пруст („По следите на изгубеното време“) успя да се промъкне едва при деветия модел – руския GigaChat, и то на девето място. Борхес не успя нито веднъж.

Имаше и по-странни дреболии. Claude, DeepSeek и Qwen включиха Тони Морисън („Beloved“). И трите я поставиха на номер десет. От цялата световна литература три различни машини бяха стигнали до една и съща книга и трите бяха решили, че столът ѝ е последният. Приличаше малко на това да хвърлиш монета три пъти и трите пъти тя да застане на ръба.

Двата китайски модела бяха единствените, които включиха Оруел („1984“). Нито един не включи китайски автор. Индийският Sarvam не включи индийски автор, но единствен включи африкански – Чинуа Ачебе („Things Fall Apart“), на десето място.

Можехме да продължим с японски, корейски и арабски модели и вероятно да превърнем една шега в таблица, а после таблицата в нещо, което прилича на научно изследване. Преди това обаче направих нещо много по-старомодно.

Попитах Google.

Ако преди появата на ChatGPT бях написал „10 greatest books of all time“, Google нямаше да ми даде свой списък. Щеше да ми покаже кой друг вече е направил такъв. Една такава класация е съставена от списъците на 125 писатели.[3]

Там Толстой („Ана Каренина“) е номер едно, Флобер („Мадам Бовари“) – номер две, а Толстой отново („Война и мир“) – номер три.[3] Следват Набоков („Лолита“), Марк Твен („Приключенията на Хъкълбери Фин“), Шекспир („Хамлет“), Фицджералд („Великият Гетсби“), Пруст („По следите на изгубеното време“), разказите на Чехов и Джордж Елиът („Мидълмарч“).[3] Достоевски го няма в десетката.

Така вече имахме три доста различни отговора. Над 130 000 души във Facebook бяха поставили „Ана Каренина“ на 83-то място, а „Престъпление и наказание“ – на 84-то.[1] В класацията на 125 писатели две книги на Толстой бяха на първо и трето място, а Достоевски беше извън десетката.[3] Девет различни езикови модела бяха избрали и Толстой, и Достоевски девет пъти от девет.

Сравнението, разбира се, не е честно. Facebook пита за книгите, които са останали с теб; писателите са съставяли свои списъци; ние питахме кои произведения един образован човек трябва да е чел. Това не са три еднакви експеримента. Но точно затова бяха интересни.

Хората във Facebook казваха какво е останало с тях. Писателите казваха кое смятат за велико. Google само намираше техните отговори. Изкуственият интелект правеше нещо друго.

Той отговаряше.

И тук въпросът вече не беше кои са десетте книги.

А кой, по дяволите, говори?

Оказа се, че не сме първите, които питат нещо подобно. През 2025 г. Paulina Toro Isaza и Nalani Kopp публикуват „The Literary Canons of Large-Language Models“.[4] В него задават на GPT-4o, Gemini 1.5 Pro и две версии на Llama различни въпроси за класически, най-добри, западни и глобални литературни произведения.[4] Полученият канон е силно западен и особено американско-британски.[4]

Самите авторки отбелязват едно важно ограничение: всички изследвани модели са разработени от американски компании и бъдещо изследване би трябвало да включи модели, създадени в други части на света.[4] Ние, без да знаем за изследването им, случайно бяхме направили точно това.

Само че това не решаваше проблема.

Големите езикови модели се обучават върху огромни количества дигитален текст – уеб страници, книги, Wikipedia, новини, научни публикации, форуми и много други източници.[5] Точните корпуси на затворените модели често не са публични.[5] Данните се подбират, филтрират, дедупликират и претеглят, а след първоначалното обучение идва последващо обучение, което учи модела как да отговаря на хора.[5]

Всеки модел беше попитан само веднъж. Генерирането е вероятностно и повторението на същия prompt може да даде различен списък.[6] На следващия ден повторихме опита с два модела. Gemini даде същия списък, Sarvam – различен.

Това беше почти прекалено удобна илюстрация на собствената ни уговорка.

Има данни, че моделите могат да възпроизвеждат структури от човешки ценности и предпочитания, съдържащи се в текстовете, върху които са обучени.[7] Има и данни, че могат да изглаждат човешките различия и да произвеждат по-силен консенсус, отколкото действително съществува сред хората.[8]

Тогава какво бяха нашите девет от девет? Не знаехме. Но вече беше трудно да наричаме това просто „канонът на изкуствения интелект“.

В огромния текстов материал, върху който се обучават моделите, са натрупани безброй човешки решения: коя книга да бъде преведена, преиздадена, преподавана, цитирана, екранизирана, препоръчвана или включена в поредния списък на великите книги. Никой не е събирал тези решения на едно място. Никой не е гласувал.

Няма световна литературна избирателна комисия, която да е преброила бюлетините и да е обявила: Толстой – избран. Достоевски – избран. Пруст – не събира необходимия процент.

Но може би резултатът от това гласуване все пак съществува. Не като списък, а като структура.

Обикновено литературният канон е нещо, което някой съставя. Правим антологии, пишем истории на литературата, определяме университетски програми и спорим кой трябва да бъде вътре и кой несправедливо е останал отвън. Зад такъв канон има човек, институция или поне група хора, които могат да бъдат обвинени за него. Тук може да става дума за нещо друго.

Никой не е взел общото решение „Хамлет“ да бъде издаван, превеждан, преподаван, игран, екранизиран и цитиран повече от произведенията на хиляди други драматурзи. Милиони хора и институции са вземали отделни решения в продължение на векове. Събрани заедно, те може би оставят статистически отпечатък.

Същото би могло да важи за Толстой („Война и мир“) и Достоевски („Престъпление и наказание“). Ако около книгите им  са  се натрупали повече издания, преводи, университетски курсове, рецензии, научни статии, споменавания, списъци и разговори, езиковият модел е обучаван върху свят, в който това натрупване вече съществува.

Тогава девет от девет започва да изглежда малко по-малко мистериозно. Само малко.

Защото това не обяснява защо Пруст („По следите на изгубеното време“) се появява едва веднъж. Не обяснява защо два китайски модела не избират нито една китайска книга. Не обяснява защо Тони Морисън („Beloved“) три пъти се оказва точно на десето място. И не обяснява защо девет модела, създадени от различни компании в различни части на света, стигат до Толстой и Достоевски девет пъти от девет.

Може би виждаме човешкия канон. Не знаем.

Че изкуственият интелект може да състави литературен канон, вече беше ясно. Интересното беше дали можем да използваме отговорите му като сонда в културата, която го е произвела.

Обикновено питаме машината какво знае. Може би понякога можем да я питаме и как изглеждаме.

Това би било чудесен край на историята, ако междувременно не бях направил една грешка.

Върнах се към онзи мой списък от Facebook. Двата Еко си останаха, както и „Параграф 22“, „Швейк“, „Фондацията“, „Синдромът Портной“, „Москва–Петушки“, „Вавилонската библиотека“ и „Пътеводител на галактическия стопаджия“. Но десетото място вече не беше същото.

Колкото и да ми беше жал, извадих Пинчън („Обявяването на серия №49“) и сложих Толкин („Властелинът на пръстените“).

После си спомних резултатите от Facebook. Сред повече от 130 000 списъка „Властелинът на пръстените“ беше номер три.[1]

Проверих деветте списъка на изкуствения интелект.

Толкин („Властелинът на пръстените“) – нула от девет.

И така успяхме да произведем още три въпроса.

Когато девет различни модела избират едни и същи автори, чий избор виждаме? Защо човешкият избор и този на машините понякога съвпадат почти абсурдно, а друг път – като при „Властелинът на пръстените“ – се разминават напълно? И ако изкуственият интелект вече участва в културата, която се опитваме да измерим чрез него, какво точно ще измерваме след десет години?

Всички въпроси, зададени в този текст, както е ясно, имат само един отговор: 42.


Бележки

[1] Lada Adamic и Pinkesh Patel, „Books That Have Stayed with Us“, Facebook Data Science, 8 септември 2014 г. Анализът използва анонимизирана извадка от повече от 130 000 Facebook статуса, публикувани през последните две седмици на август 2014 г. Най-често посочваните книги са поредицата „Хари Потър“, „Да убиеш присмехулник“ и „Властелинът на пръстените“; „Ана Каренина“ е на 83-то място, а „Престъпление и наказание“ – на 84-то.

[2] Ahrefs, „100 Most Asked Questions on Google (July 2026)“. В глобалната класация „What is the meaning of life?“ е на 75-то място с приблизително 170 000 търсения месечно. Вж. също Google Australia, „A Year in Search: The Moments that Defined 2016“, където въпросът е №10 сред най-търсените въпроси, започващи с „What is…?“.

[3] J. Peder Zane, съст., The Top Ten: Writers Pick Their Favorite Books (New York: W. W. Norton, 2007). Класацията е съставена въз основа на списъци, предоставени от 125 писатели. Общата десетка започва с „Ана Каренина“, „Мадам Бовари“ и „Война и мир“, следвани от „Лолита“, „Приключенията на Хъкълбери Фин“, „Хамлет“, „Великият Гетсби“, „По следите на изгубеното време“, разказите на Чехов и „Мидълмарч“.

[4] Paulina Toro Isaza и Nalani Kopp, „The Literary Canons of Large-Language Models: An Exploration of the Frequency of Novel and Author Generations Across Gender, Race and Ethnicity, and Nationality“, Proceedings of the 5th International Conference on Natural Language Processing for Digital Humanities (NLP4DH 2025), с. 214–231. DOI: 10.18653/v1/2025.nlp4dh-1.19. Авторките изследват GPT-4o, Gemini 1.5 Pro, Llama 3.3 70B-Instruct и Llama 3.1 8B-Instruct. Получените литературни канони са преобладаващо западни, с особено силно присъствие на бели американски и британски автори.

[5] Големите езикови модели първо се обучават върху големи масиви от текстови и други данни, след което преминават през допълнително обучение. Точният състав на обучителните корпуси на затворените модели обикновено не се разкрива изцяло. Вж. например Anthropic, „Transparency Hub“; както и Toro Isaza и Kopp, „The Literary Canons of Large-Language Models“, с. 216–217.

[6] Генерирането от езиковите модели е вероятностно: в зависимост от параметрите на семплиране и конкретната реализация повторното задаване на един и същ prompt може да произведе различни отговори. Вж. Microsoft, „Best Practices for the Phi Silica LanguageModel API“, раздел „Handling non-deterministic output“; Mistral AI, „Temperature“, Mistral AI Cookbook.

[7] Yan Tao, Olga Viberg, Ryan S. Baker и René F. Kizilcec, „Cultural Bias and Cultural Alignment of Large Language Models“, PNAS Nexus 3, № 9 (2024): pgae346. DOI: 10.1093/pnasnexus/pgae346. Съпоставяйки отговорите на големи езикови модели с национално представителни данни от World Values Survey, авторите установяват систематични културни модели в отговорите, като изразените ценности се доближават най-силно до тези в англоезичните и протестантските европейски общества.

[8] Krishna Pothugunta и John P. Lalor, „Carefully Considering Culture: Analyzing LLM Alignment in Single- and Multi-Cultural Settings Using Cultural Consensus Theory“, Findings of the Association for Computational Linguistics: ACL 2026, с. 26571–26582. DOI: 10.18653/v1/2026.findings-acl.1323. Съпоставяйки отговорите на моделите с данни от World Values Survey за десет държави и дванадесет тематични области, авторите установяват, че моделите могат силно да свръхрегуляризират културния консенсус и да заличават част от различията между хората.


ИЗПОЛЗВАНА ЛИТЕРАТУРА

Adamic, Lada, and Pinkesh Patel. “Books That Have Stayed with Us.” Facebook Data Science, 8 September 2014.

Ahrefs. “100 Most Asked Questions on Google (July 2026).” Последен достъп: август 2026.

Anthropic. “Transparency Hub.” Документация за обучението и данните на моделите. Последен достъп: август 2026.

Google Australia. “A Year in Search: The Moments that Defined 2016.” 2016.

Microsoft. “Best Practices for the Phi Silica LanguageModel API.” Раздел “Handling Non-Deterministic Output.” Последен достъп: август 2026.

Mistral AI. “Temperature.” Mistral AI Cookbook. Последен достъп: август 2026.

Pothugunta, Krishna, and John P. Lalor. “Carefully Considering Culture: Analyzing LLM Alignment in Single- and Multi-Cultural Settings Using Cultural Consensus Theory.” Findings of the Association for Computational Linguistics: ACL 2026, 26571–26582. https://doi.org/10.18653/v1/2026.findings-acl.1323.

Tao, Yan, Olga Viberg, Ryan S. Baker, and René F. Kizilcec. “Cultural Bias and Cultural Alignment of Large Language Models.” PNAS Nexus 3, no. 9 (2024): pgae346. https://doi.org/10.1093/pnasnexus/pgae346.

Toro Isaza, Paulina, and Nalani Kopp. “The Literary Canons of Large-Language Models: An Exploration of the Frequency of Novel and Author Generations Across Gender, Race and Ethnicity, and Nationality.” Proceedings of the 5th International Conference on Natural Language Processing for Digital Humanities (NLP4DH 2025), 214–231. https://doi.org/10.18653/v1/2025.nlp4dh-1.19.

Zane, J. Peder, ed. The Top Ten: Writers Pick Their Favorite Books. New York: W. W. Norton, 2007.


сп. „Нова социална поезия“, ноември 2026, ISSN 2603-543X
 

Александър Джоганов – Hamlet не е Hamlet: Канонично насищане и разширяване на критическия обект

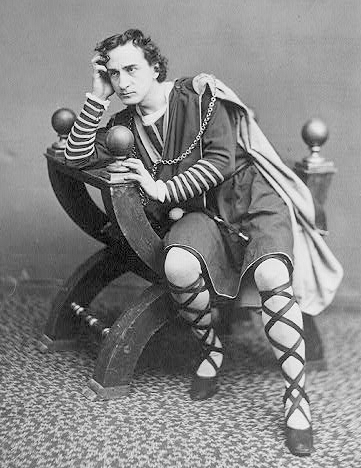
Hamlet portrayed by Edwin Booth (c. 1870)


Увод

Hamlet не е Hamlet.

Поне не и през 2026 г.

За съвременния литературовед зад това име стои не само Шекспировата пиеса. Зад нея се трупат повече от четири века издания и коментари, монографии и статии, дисертации и библиографии, постановки, спорове, интерпретации на интерпретациите и, напоследък, дигитални инструменти, създадени, за да ни помогнат да се ориентираме в самото натрупване. Четири века канонично присъствие са дали на Hamlet необикновено дълга сянка. Днес изследователят трудно може да се приближи до пиесата, без да влезе и в нея.

Обикновено наричаме всичко това ресурс и с основание. Предходната критика ни помага да четем Hamlet, библиографиите ни казват къде да я намерим, дигиталните бази съкращават търсенето, а натрупаното знание позволява следващият прочит да започне от постигнатото преди него. Но успехът има странен предел. Колкото повече знаем за Hamlet, толкова повече трябва да знае човекът, който иска да каже нещо ново за него. Не е достатъчно една интерпретация да бъде убедителна и продуктивна. Ако претендира за новост, остава неприятният въпрос дали някой не я е предложил вече — преди пет, петдесет или триста години, на английски, немски или френски, или в дисертация, която отдавна никой не цитира.

Така цената на новата идея започва да включва и проверката дали тя действително е нова. В други области този проблем е описван като „товар на знанието“ (burden of knowledge): всяко поколение наследява повече знание и трябва да измине по-дълъг път, преди да достигне границата, отвъд която може да добави свое.[1] При крайно канонизиран литературен текст натрупването има и една особена форма. То не се разпределя равномерно върху литературното поле, а се концентрира около малък брой произведения, които именно защото са успешни, непрекъснато привличат още внимание. Статистическите изследвания на шекспироведската библиография показват ясно това неравномерно разпределение.[2]

Hamlet е особено удобен случай, защото натрупването около него е достатъчно голямо, за да се вижда самият механизъм. Появата на специализирани библиографии и дигитални инструменти за ориентация в литературата върху Hamlet е симптом сама по себе си: ресурсът е станал толкова голям, че е породил нов ресурс, необходим за собственото му управление.[3]

Тази пределна точка ще наричам „канонично насищане“ (canonical saturation). За Hamlet очевидно продължава да се пише. Натрупаното знание обаче вече не само подпомага следващите изследвания, а участва и в преценката дали едно ново твърдение наистина е ново.

Идеята следва модел на литературната комуникация, развит в три предходни текста: Literary Survival as a Problem of Communication, The Lost Literature и The Canon as a Communication Resource.[4] В тях са разгледани литературното оцеляване като комуникационен проблем, ограничеността и неравномерното разпределение на комуникационния ресурс и способността на канона да концентрира още ресурс около вече силните текстове. Hamlet не участва в изграждането на този модел и затова тук може да послужи като външен тест на крайния му случай.

Резултатът е парадоксален. Комуникационният ресурс е запазил Hamlet изключително успешно: пиесата е достъпна, видима и почти неизбежна. Същото натрупване обаче увеличава цената на следващото твърдение за нея. А когато излезе от монографиите и библиографиите и премине в училището, театъра, киното, езика и всекидневната култура, се появява и втори ефект: част от „втория Hamlet“ достига до читателя още преди първия.

Можеш да решиш да не отвориш нито една монография. Много по-трудно е да решиш да не отвориш собствената си памет.

Затова тази статия ще се занимава сравнително малко с Шекспировия Hamlet и много повече с онова, което четири века са натрупали около него. Първият може да бъде прочетен за няколко часа. Вторият никой отделен човек вече не може да прочете целия. Първият има край; вторият продължава да расте. И ако това беше проблем само на литературоведите, бихме могли спокойно да ги оставим да се оправят с него. Но вторият Hamlet отдавна е напуснал библиотеката.

Проблемът вече не е само, че никой не може да прочете всичко написано за Hamlet. По-странното е, че почти никой вече не може да прочете само Hamlet.


БЕЛЕЖКИ

    1. За „товара на знанието“ (burden of knowledge) вж. Benjamin F. Jones, “The Burden of Knowledge and the ‘Death of the Renaissance Man’: Is Innovation Getting Harder?,” Review of Economic Studies 76, no. 1 (2009): 283–317. Jones разглежда натрупването на предходно знание като фактор, който увеличава предварителната инвестиция, необходима за достигане до границата на новото знание. Тук механизмът се използва за по-тесния случай на локално натрупване на критическо знание около силно канонизиран литературен обект.
    2. Вж. Laura Estill, Dominic Klyve, and Kate Bridal, “‘Spare your arithmetic, never count the turns’: A Statistical Analysis of Writing about Shakespeare, 1960–2010,” Shakespeare Quarterly 66, no. 1 (2015): 1–28. Анализът на World Shakespeare Bibliography показва значителна неравномерност в разпределението на критическото внимание между произведенията на Шекспир. Данните са основание Hamlet да бъде разглеждан като краен случай на критическо натрупване, а не като произведение с изчерпани интерпретативни възможности.
    3. Вж. Harmonie Loberg, “Hamlet Haven: An Online, Annotated Bibliography” (MA thesis, University of South Florida, 2002). Hamlet Haven е специализиран инструмент за ориентация в критическата литература върху Hamlet и затова е особено ясен пример за ресурс, създаден за управление на вече натрупан ресурс. За по-широката връзка между Шекспир и дигиталната изследователска инфраструктура вж. Laura Estill, “Digital Humanities’ Shakespeare Problem,” Humanities 8, no. 1 (2019).
    4. Alex Dzhoganov, Literary Survival as a Problem of Communication; Alex Dzhoganov, The Lost Literature; Alex Dzhoganov, The Canon as a Communication Resource. Unpublished manuscripts. Трите текста разглеждат съответно литературното оцеляване като комуникационен проблем, ограничеността и неравномерното разпределение на комуникационния ресурс и способността на каноничните структури да концентрират и възпроизвеждат този ресурс. Hamlet не участва в изграждането на модела и тук служи като външен краен случай.


І. ВТОРИЯТ HAMLET

Първият Hamlet има сравнително ясни граници — доколкото изобщо можем да говорим за един първи Hamlet. Още тук думата „оригинал“ е неудобна. Q1 от 1603 г., Q2 от 1604/1605 г. и текстът в First Folio от 1623 г. не са идентични, а отношенията между тях имат собствена дълга текстологична история.[5] Съвременният читател, който купува „Hamlet“, обикновено държи в ръцете си и резултата от векове редакторски решения.

Можем засега да оставим този проблем на шекспироведите и условно да приемем, че първият Hamlet е текстът, който искаме да прочетем. Вторият няма никакви подобни граници.

Той расте като дърво, което всяка година добавя нов пръстен, без да губи старите. Само че това дърво отдавна е надхвърлило General Sherman — най-голямото живо единично дърво на Земята по обем.[6] General Sherman все пак има физически граници. Критическата литература върху Hamlet не показва подобни намерения.

Всяка година към нея се добавят нови статии, книги, дисертации, издания и интерпретации. Следващата година не започва от Hamlet, а от Hamlet плюс всичко, което вече е натрупано около него. Популярността може да расте и да спада; натрупаният критически корпус има памет. Една статия може да престане да бъде четена, но не престава да съществува. Ако следващ изследовател претендира за новост, забравен текст от 1897 г. внезапно може отново да стане важен.

Данните от World Shakespeare Bibliography позволяват поне част от този растеж да бъде видян. Анализът на Laura Estill, Dominic Klyve и Kate Bridal върху библиографските записи за периода 1960–2010 показва силно неравномерно разпределение на критическото внимание между произведенията на Шекспир, като Hamlet е сред най-интензивно изследваните.[7] Не е необходимо да преброим целия корпус, за да видим проблема. Достатъчно е, че той е станал толкова голям, че вече има собствена инфраструктура за ориентация.

Hamlet Haven е почти комично добър пример.[8] Harmonie Loberg създава специализирана онлайн анотирана библиография за Hamlet. Територията вече е толкова обширна, че ни трябва карта на картите.

А след нея — начин да се ориентираме сред картите.

Вторият Hamlet започва да прилича на образ между две успоредни огледала. Пиесата поражда критика, критиката — метакритика, натрупването — библиографии, а библиографиите и базите данни — инструменти за ориентация в самите тях. Всяко следващо отражение съдържа предишното и отваря още едно зад себе си. Всички тези инструменти са полезни. Тъкмо в това е парадоксът: колкото по-добре културата пази, описва и организира Hamlet, толкова по-голям става Hamlet, който следващият изследовател наследява.

Но вторият Hamlet отдавна не стои само в библиотеката. Четири века интерпретации са преминали в театъра, киното, училището, езика, изображенията, цитатите и пародиите. Черепът е вероятно най-очевидният пример. Образът на Hamlet с череп в ръка е станал почти универсален знак за пиесата, макар знаменитото „To be or not to be“ да принадлежи на съвсем друга сцена. Културната памет спокойно ги събира в едно.

Hamlet е оцелял толкова добре, че огромна част от културата вече го познава, преди да го прочете. Физическият достъп до текста никога не е бил по-лесен; културно необремененият достъп до него вероятно никога не е бил по-труден. Канонът е запазил Hamlet почти съвършено и тъкмо с това е направил почти невъзможно да го срещнем сам.

Hamlet вече не може да върви сам в мрака и в известен смисъл не може да има истински монолог. Преди да произнесе първата си дума, около него вече говорят четири века чужди гласове. Читателят може да отвори пиесата сам, но срещата бързо започва да прилича по-малко на празната сцена на Елсинор и повече на лондонското метро в час пик.

Човек все още може да прочете Hamlet по свой начин, но едва ли от нулева културна точка. Дори да не отворим критиците, носим със себе си онова, което вече знаем.

Тук „вторият Hamlet“ вече не означава само библиографския корпус. В него влиза целият натрупан слой, който участва в следващата среща с произведението — независимо дали тя е научна статия, театрална постановка или първото четене на човек, който никога преди това не е отварял пиесата.

Каноничното натрупване прави Hamlet необикновено лесен за намиране, четене и изучаване. Друго е да го срещнем без знанието, което вече носим в паметта си.

Вторият Hamlet е станал част от начина, по който четем първия.


БЕЛЕЖКИ

  1. За ранната текстова история на Hamlet вж. William Shakespeare, Hamlet, ed. Ann Thompson and Neil Taylor, The Arden Shakespeare, Third Series (London: Bloomsbury, 2006). First Quarto (Q1, 1603), Second Quarto (Q2, 1604/1605) и First Folio (F1, 1623) съдържат значителни различия и стоят зад дълъг редакторски и текстологичен спор. Тук въпросът остава извън анализа; достатъчно е, че дори условно нареченият „първи Hamlet“ не е напълно безпроблемен текстов обект.
  2. General Sherman е гигантска секвоя (Sequoiadendron giganteum) в Giant Forest, Sequoia National Park, Калифорния, определяна като най-голямото живо единично дърво в света по обем на ствола. Сравнението е образно.
  3. Laura Estill, Dominic Klyve, and Kate Bridal, “‘Spare your arithmetic, never count the turns’: A Statistical Analysis of Writing about Shakespeare, 1960–2010,” Shakespeare Quarterly 66, no. 1 (2015): 1–28. Анализът на World Shakespeare Bibliography показва устойчиво концентриране на критическото внимание върху ограничен брой произведения, сред които Hamlet.
  4. Harmonie Loberg, “Hamlet Haven: An Online, Annotated Bibliography” (MA thesis, University of South Florida, 2002). Специализираната библиография е ресурс от втори ред, създаден за ориентация във вече натрупания критически ресурс.


ІІ. КОГАТО РЕСУРСЪТ СЕ ПРЕВЪРНЕ В ЦЕНА

Натрупването на знание има очевидно предимство: следващият изследовател не започва от нулата. При Hamlet това предимство вероятно никога не е било по-голямо. Текстове, издания, библиографии и бази данни са достъпни с бързина, за която поколения шекспироведи не са могли да мечтаят. Натрупаният комуникационен ресурс скъсява пътя до предходното знание.

Предходното знание обаче продължава да се натрупва. Достъпът става по-евтин, докато установяването на новостта на едно твърдение може да изисква все повече работа.

Да имаш „нова“ идея за Hamlet не е непременно трудно. Тя може да се появи още при първото четене, в една сцена, една реплика, дори една дума. Трудното започва след това: трябва да разбереш дали кавичките около „нова“ могат да бъдат махнати. Някой писал ли е същото през 1964 г.? А през 1912? Има ли близка формулировка в книга, която не е дигитализирана? В дисертация? На друг език? Под друго теоретично понятие? Колко далеч трябва да стигне проверката, преди изследователят разумно да може да каже: това е ново?

До идеята може да има една страница. Зад доказателството за нейната новост стоят четири века.

Това е литературоведският вариант на описания от Benjamin F. Jones „товар на знанието“.[9] При Hamlet обаче изследователят не просто трябва да знае повече, за да разбере обекта си. Натрупаното знание определя и статуса на следващото му твърдение.

Никой не прочита всичко написано за Hamlet. Работим чрез подбор — проблем, период, теоретична традиция, език, корпус. Иначе изследването би било невъзможно. Но подборът не кара останалото да изчезне. Забравена статия си остава забравена само докато някой не открие, че в нея през 1937 г. вече е формулирана неговата „нова“ идея.

Информационното претоварване означава, че материалът е повече, отколкото човек може да обработи.[10] При каноничното насищане възниква и друга трудност: непрочетен текст може да промени статуса на твърдение, което вече си написал.

Можеш никога да не си виждал един текст и той пак да е достатъчен, за да направи идеята ти стара.

Абсолютното доказване на новост, разбира се, е невъзможно. Академичната работа винаги поставя разумни граници на проверката. Но колкото повече расте корпусът, толкова по-трудно става да решим къде са тези граници. В един момент изчерпателната проверка вече не е просто трудна. За един човешки живот тя е практически невъзможна.

Ако цената на новото критическо знание расте, логично би било постепенно да се произвежда по-малко от него. Hamlet очевидно не е получил съобщението.

Критическата продукция продължава.[11] Всеки нов текст влиза в корпуса, спрямо който следващият трябва да доказва новостта си. Получава се странна машина: повече критика → по-голям корпус за проверка → по-висока цена за установяване на новостта → още критика → още по-голям корпус.

Цената расте, но машината не спира.

Точно тук комуникационният ресурс показва неочаквана страна. В трите предходни текста той работи преди всичко в полза на литературното оцеляване: достъпът, вниманието, институциите и възпроизводството увеличават шанса един текст да остане в обращение.[12] Hamlet е почти неприлично успешен по всички тези показатели. Той е получил издания, преводи, библиотеки, училища, университети, сцени, филми, критика, цитати и дигитална достъпност. Ако литературното оцеляване има история на успеха, Hamlet е близо до крайния ѝ случай.

Тъкмо в този предел цената става видима. Ресурсите, които пазят Hamlet, продължават да улесняват достъпа до пиесата. Но проверката дали една идея за нея е нова все още може да струва много.

При читателя проблемът е друг. Материалният Hamlet е по-достъпен от всякога: можем да го купим, свалим, потърсим, сравним и прочетем почти веднага. Но до него вече води път, покрит с резултатите от собствения му успех. Критикът не може да провери целия натрупан Hamlet; обикновеният читател не може напълно да го забрави. При единия вторият Hamlet стои пред новото твърдение, при другия – пред първата страница.

Това е точката, в която въпросът за оцеляването се обръща. Един текст може да стане недостъпен, защото не е оцелял. Но крайният успех подсказва и обратната възможност: текстът да е навсякъде и въпреки това срещата с него да става все по-малко непосредствена.

Hamlet не е изчезнал.

Той е оцелял толкова добре, че вече трудно идва сам.


БЕЛЕЖКИ

  1. Benjamin F. Jones, “The Burden of Knowledge and the ‘Death of the Renaissance Man’: Is Innovation Getting Harder?,” Review of Economic Studies 76, no. 1 (2009): 283–317. Jones свързва натрупването на знание с увеличаване на предварителната инвестиция, необходима за достигане до границата на новото знание, както и с нарастваща специализация. Тук механизмът се пренася към натрупването на критическо знание около един каноничен литературен обект.
  2. За по-общия проблем на информационното претоварване вж. Maurice S. Lee, Overwhelmed: Literature, Aesthetics, and the Nineteenth-Century Information Revolution (Princeton: Princeton University Press, 2019). Разликата тук е, че непрочетената част от корпуса не само затруднява обработването на информацията, а може да промени статуса на следващото твърдение за новост.
  3. Вж. Laura Estill, Dominic Klyve, and Kate Bridal, “‘Spare your arithmetic, never count the turns’: A Statistical Analysis of Writing about Shakespeare, 1960–2010,” Shakespeare Quarterly 66, no. 1 (2015): 1–28. Данните показват устойчивата концентрация на критическо внимание върху ограничен набор произведения, сред които Hamlet. Те не доказват безкрайно нарастване на корпуса; тук са достатъчни като свидетелство, че високата цена на новостта не е прекратила критическата продукция.
  4. Вж. Dzhoganov, Literary Survival as a Problem of Communication; The Lost Literature; The Canon as a Communication Resource. При Hamlet моделът стига до граничен случай: ресурсът остава положителен за оцеляването на произведението, но натрупването му увеличава цената на определени следващи операции и част от него се превръща в културна памет, която предхожда новото четене.


ЗАКЛЮЧЕНИЕ

Използвах Hamlet, за да разгледам предела на един по-общ механизъм: литературният успех произвежда ресурс, ресурсът привлича внимание, вниманието произвежда още ресурс. Достатъчно дълго повтарян, този процес създава втори обект около каноничния текст.

При Hamlet сянката вече е несъизмеримо по-голяма от текста, който я хвърля. Първият все още може да бъде прочетен за няколко часа — ако оставим настрана неудобния въпрос кой точно Hamlet наричаме „първи“. Вторият е трупан повече от четири века: издания, постановки, монографии, статии, дисертации, библиографии, филми, училищни прочити, цитати, пародии и образи.

Самият текст не е изчезнал под тях. Тъкмо обратното. Може би никога не е било толкова лесно да намериш Hamlet и толкова трудно да го срещнеш сам. Тук Hamlet застава почти огледално срещу един от случаите в The Lost Literature. Втората книга на Аристотеловата „Поетика“ не можем да прочетем, защото я няма. Знаем за нея, можем да я реконструираме по следите ѝ и да спорим какво е съдържала, но самият текст не е достигнал до нас. При Hamlet се случва почти обратното: текстът е достигнал до нас с огромен запас от комуникационен ресурс и заедно с него са пристигнали четири века четене.

Единият текст не можем да прочетем, защото го няма. Другият вече трудно можем да прочетем сами, защото го има прекалено много. При изгубената „Поетика“ между нас и текста стои празнота. При Hamlet стои тълпа.

Канонът е изпълнил задачата си почти съвършено. Hamlet е оцелял, превеждан е, поставян е, преподаван е, екранизиран е и е достъпен практически навсякъде. Но същият успех е натрупал около него толкова много четене, че между пиесата и съвременния читател вече стои историята на нейното собствено оцеляване.

За изследователя натрупването увеличава цената да установи дали една „нова“ идея заслужава да остане без кавички. За останалите читатели последиците идват още по-рано — преди първата страница.

Така комуникационният ресурс не се обръща срещу произведението. Без него Hamlet вероятно нямаше да бъде Hamlet през 2026 г. Но крайният случай показва нещо, което при по-малко успешните текстове остава скрито: оцеляването също може да има цена. Един текст може да бъде запазен толкова добре, че натрупаното около него да стане част от самата среща с него.

Днес Hamlet е и четирите века четене, натрупани около пиесата.

Остава един малък рекурсивен проблем. Всеки текст, който се опитва да измери сянката на Hamlet, я удължава още малко. Тази статия не прави изключение: докато описва натрупването на критическа литература върху Hamlet, тя добавя още един текст към него.

Вторият Hamlet расте като дърво от четири века и някъде по пътя отдавна е надхвърлил General Sherman. За разлика от General Sherman обаче голяма част от растежа му традиционно е изисквала хартия.

Няма да изчисляваме колко гора вече е струвал Hamlet.

Ще трябва да напишем още една статия.


БЕЛЕЖКИ

  1. За изгубената втора книга на Аристотеловата Поетика и нейното последващо присъствие чрез свидетелства, реконструкции и културна памет вж. Alex Dzhoganov, The Lost Literature, unpublished manuscript. Тук случаят се използва като противоположен предел на Hamlet: материална липса при продължаващ комуникационен ресурс срещу материално изобилие и крайно натрупване на ресурс.


ИЗПОЛЗВАНА ЛИТЕРАТУРА

Dzhoganov, Alex. Literary Survival as a Problem of Communication. Unpublished manuscript.

Dzhoganov, Alex. The Lost Literature. Unpublished manuscript.

Dzhoganov, Alex. The Canon as a Communication Resource. Unpublished manuscript.

Estill, Laura. “Digital Humanities’ Shakespeare Problem.” Humanities 8, no. 1 (2019).

Estill, Laura, Dominic Klyve, and Kate Bridal. “‘Spare your arithmetic, never count the turns’: A Statistical Analysis of Writing about Shakespeare, 1960–2010.” Shakespeare Quarterly 66, no. 1 (2015): 1–28.

Jones, Benjamin F. “The Burden of Knowledge and the ‘Death of the Renaissance Man’: Is Innovation Getting Harder?” Review of Economic Studies 76, no. 1 (2009): 283–317.

Lee, Maurice S. Overwhelmed: Literature, Aesthetics, and the Nineteenth-Century Information Revolution. Princeton: Princeton University Press, 2019.

Loberg, Harmonie. “Hamlet Haven: An Online, Annotated Bibliography.” MA thesis, University of South Florida, 2002.

Shakespeare, William. Hamlet. Edited by Ann Thompson and Neil Taylor. The Arden Shakespeare, Third Series. London: Bloomsbury, 2006.

World Shakespeare Bibliography. Folger Shakespeare Library.


сп. „Нова социална поезия“, ноември 2026, ISSN 2603-543X